
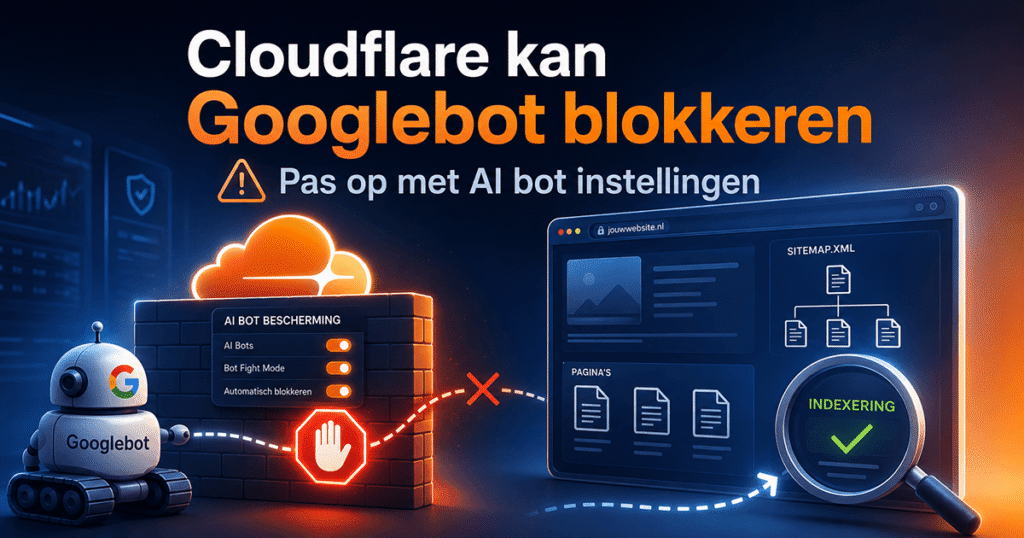
Cloudflare AI bots blokkeren zonder Googlebot en je AI zichtbaarheid te verliezen
Wil je voorkomen dat je websitecontent zomaar wordt gebruikt voor het trainen van AI modellen? Dan lijkt AI bots blokkeren via Cloudflare een logische keuze.
Maar pas op met wat je blokkeert.
Vanaf 15 september 2026 kan het blokkeren van AI Training binnen Cloudflare namelijk ook gevolgen hebben voor Googlebot, Bingbot en Applebot. Dat kan uiteindelijk je vindbaarheid in zoekmachines raken.
Tegelijkertijd wil je waarschijnlijk niet alle AI toegang tot je website onmogelijk maken. Steeds meer mensen zoeken en vergelijken via ChatGPT, Claude, Gemini en andere AI platformen. Je wilt dus controle houden over AI training, zonder onnodig kansen op zichtbaarheid in zoekmachines en AI antwoorden te verliezen.
Gebruik je Cloudflare? Dan is het verstandig om je instellingen vóór 15 september te controleren.
Let op: Googlebot en Bingbot kunnen worden geblokkeerd
Dit is de belangrijkste verandering om rekening mee te houden.
Cloudflare beschouwt onder andere Googlebot, Bingbot en Applebot als mixed purpose crawlers. Dit zijn crawlers die voor meerdere toepassingen worden gebruikt.
Vanaf 15 september 2026 kijkt Cloudflare bij deze crawlers naar alle functies waarvoor ze worden gebruikt. De meest beperkende instelling kan vervolgens bepalen of toegang wordt toegestaan.
Heb je Training op Block staan? Dan kunnen volgens Cloudflare mixed purpose crawlers zoals Googlebot, Bingbot en Applebot worden geblokkeerd.
Dat is belangrijk voor SEO.
Als Googlebot structureel een HTTP 403 response krijgt, kan Google pagina’s niet normaal crawlen. Dat kan uiteindelijk gevolgen hebben voor het ontdekken van nieuwe pagina’s, het verwerken van wijzigingen en je organische vindbaarheid.
Hetzelfde geldt voor belangrijke bestanden zoals je robots.txt en XML sitemap.
Wil je meer weten over het structureel verbeteren van je vindbaarheid? Lees dan ook meer over zoekmachine optimalisatie.
Wat verandert Cloudflare op 15 september 2026?
Cloudflare introduceert vanaf 15 september nieuwe standaardinstellingen voor nieuwe domeinen.
Search blijft standaard toegestaan. Training en Agent worden op pagina’s met advertenties standaard geblokkeerd.
Voor bestaande websites is vooral de verandering rond mixed purpose crawlers belangrijk.
Vanaf 15 september kunnen crawlers die zowel voor Search als Training worden gebruikt ook worden geraakt wanneer je Training blokkeert.
Cloudflare noemt zelf Googlebot, Applebot en Bingbot als voorbeelden.
Gebruik je de oudere instelling Block AI bots? Ook dan is controle nodig. Cloudflare faseert deze instelling op 15 september uit en de behandeling van mixed purpose crawlers verandert.
Bestaande Cloudflare klanten kunnen vóór 15 september in hun Security settings aangeven dat zij de nieuwe instelling voor Training crawlers die ook voor Search worden gebruikt niet willen overnemen.
Controleer dit dus vóór de deadline.
Cloudflare legt de wijziging uit in de officiële aankondiging over de nieuwe AI traffic instellingen.
Waarom AI bots blokkeren steeds ingewikkelder wordt
Het probleem is dat een bot niet meer automatisch één functie heeft.
Cloudflare maakt daarom onderscheid tussen drie toepassingen.
| Categorie | Functie |
|---|---|
| Search | Content verzamelen en indexeren voor zoektoepassingen |
| Agent | Actuele informatie ophalen of acties uitvoeren namens een gebruiker |
| Training | Content gebruiken om AI modellen te trainen of verder te verbeteren |
Voor een bedrijf dat online gevonden wil worden, hebben deze toepassingen verschillende waarden.
Je wilt misschien niet dat je complete website wordt gebruikt om een AI model te trainen. Maar je wilt waarschijnlijk wel vindbaar blijven in Google.
En je wilt mogelijk ook dat actuele informatie van je website kan worden gevonden wanneer iemand ChatGPT, Claude, Gemini of een andere AI toepassing gebruikt.
Daarom is alle AI bots blokkeren geen goed uitgangspunt.
AI training blokkeren is niet hetzelfde als AI zichtbaarheid beperken
Dit onderscheid wordt steeds belangrijker.
Niet willen dat je content voor AI training wordt gebruikt, betekent niet dat je onzichtbaar wilt worden voor AI.
Mensen gebruiken AI platformen steeds vaker tijdens hun oriëntatie. Ze stellen vragen, vergelijken oplossingen en zoeken naar bedrijven, producten en diensten.
Als jouw website een goed antwoord bevat, wil je juist de mogelijkheid behouden dat je bedrijf of content binnen zulke toepassingen wordt gevonden of als bron wordt gebruikt.
Toegang geven aan een crawler is overigens geen garantie dat ChatGPT, Claude, Gemini of een ander platform je website daadwerkelijk noemt.
Maar wanneer je relevante crawlers en agents volledig blokkeert, kun je mogelijkheden voor ontdekking en actueel gebruik van je content beperken.
De vraag wordt daarom niet alleen:
Wil ik AI training toestaan?
Maar ook:
Voor welke toepassingen wil ik dat mijn website toegankelijk blijft?
Training Disallow en Training Block zijn niet hetzelfde
Dit is een belangrijk verschil als je je Cloudflare instellingen gaat aanpassen.
Training Disallow geeft via robots.txt aan dat je niet wilt dat je content voor AI training wordt gebruikt.
Training Block houdt verkeer technisch tegen aan de rand van het Cloudflare netwerk.
Zet je Training op Block, dan kan Cloudflare dus ook mixed purpose crawlers zoals Googlebot, Bingbot en Applebot blokkeren.
Dat is iets heel anders dan aangeven dat je content niet voor Training mag worden gebruikt.
Voor een website die afhankelijk is van organische vindbaarheid is dit onderscheid essentieel.
Bot Preference Sync helpt dit probleem oplossen
Cloudflare introduceerde hiervoor in augustus 2026 Bot Preference Sync.
Deze functie doet meer dan alleen je Cloudflare instellingen en robots.txt met elkaar synchroniseren.
Cloudflare kan hiermee je voorkeuren voor verschillende vormen van gebruik kenbaar maken zonder automatisch iedere mixed purpose crawler technisch te blokkeren.
Daarbij gebruikt Cloudflare zogenaamde Content Signals.
Daarmee kunnen onder andere deze voorkeuren worden vastgelegd:
search=yes
ai-input=yes of ai-input=no
ai-train=no
search gaat over het bouwen van een zoekindex en het leveren van zoekresultaten.
ai-input gaat over het gebruiken van je content als actuele input voor een AI model, bijvoorbeeld bij grounding of het beantwoorden van een vraag.
ai-train gaat over het trainen of verder ontwikkelen van een AI model.
Hierdoor kun je bijvoorbeeld aangeven:
Search mag wel.
Actueel gebruik door AI mag eventueel wel.
Training mag niet.
Dat is veel nauwkeuriger dan alle AI bots technisch blokkeren.
Cloudflare beschrijft de werking van deze Content Signals in de documentatie over Content Signals.
Wat betekent Disallow in de praktijk?
Een belangrijk punt blijft dat robots.txt en Content Signals voorkeuren communiceren.
Ze vormen geen technische beveiliging.
Een crawler moet ervoor kiezen deze voorkeuren te respecteren.
Wil je een crawler daadwerkelijk geen toegang geven? Dan is een technische Block nodig.
Daarom moet je onderscheid maken tussen betrouwbare crawlers die je voorkeuren respecteren en crawlers die dat niet doen.
Juist daar komt AI Crawl Control om de hoek kijken.
Gebruik AI Crawl Control voor gerichte blokkades
Met AI Crawl Control kun je beter bekijken welke AI crawlers je website bezoeken en individuele crawlers beoordelen.
Dat is voor veel websites verstandiger dan één algemene blokkade.
Een crawler die uitsluitend ongewenst content verzamelt en je voorkeuren negeert, wil je misschien technisch blokkeren.
Googlebot wil je juist toegang blijven geven omdat je afhankelijk bent van Google Search.
En bij AI agents kan het interessant zijn om eerst te onderzoeken waarvoor ze toegang nodig hebben voordat je ze automatisch buitensluit.
Zo houd je controle zonder alle crawlers over één kam te scheren.
Hoe zit het met Google Extended en Gemini?
Google heeft daarnaast een eigen mechanisme: Google Extended.
Daar bestaat nogal wat verwarring over.
Google Extended is geen aparte crawler. Google gebruikt bestaande crawlers zoals Googlebot om content op te halen. Google Extended is een token waarmee je aangeeft wat Google daarna met die content mag doen.
Je kunt Google Extended gebruiken om bepaald gebruik voor Gemini Apps, de Vertex AI API voor Gemini en grounding te beheren.
Volgens Google heeft Google Extended geen invloed op de opname van je website in Google Search en is het geen rankingfactor.
Maar let op: Google Extended bepaalt niet of je content in AI Overviews en AI Mode binnen Google Search verschijnt.
AI Overviews en AI Mode zijn onderdelen van Google Search.
Wil je beperken hoeveel content Google daar kan tonen of gebruiken, dan zijn instellingen zoals nosnippet, max-snippet, data-nosnippet en noindex relevant.
Google legt dit onderscheid uit in de documentatie over AI functies binnen Google Search.
En ChatGPT, Claude en andere AI platformen?
Ook hier geldt dat je niet alle AI systemen als één categorie kunt behandelen.
Aanbieders gebruiken verschillende crawlers en technieken voor Training, Search en het actueel ophalen van informatie.
Er bestaat daarom geen universele instelling waarmee je zegt:
Gebruik mijn content niet voor training, maar zorg wel dat mijn bedrijf in alle AI antwoorden wordt genoemd.
Zichtbaarheid werkt niet zo eenvoudig.
Wel is duidelijk dat het volledig blokkeren van relevante crawlers of agents je mogelijkheden kan beperken.
Voor bedrijven ontstaat daarom naast traditionele SEO een nieuwe vraag: welke toegang hebben AI systemen nodig om mijn bedrijf en content te kunnen ontdekken en gebruiken wanneer iemand naar mijn producten, diensten of expertise zoekt?
Dat maakt crawlerbeheer steeds meer onderdeel van je bredere strategie voor online vindbaarheid.
Vergeet WAF regels en Bot Fight Mode niet
Een crawler toestaan binnen AI Crawl Control betekent niet automatisch dat hij je website daadwerkelijk kan bereiken.
Andere Cloudflare instellingen kunnen verkeer alsnog tegenhouden.
Denk aan Bot Fight Mode, Super Bot Fight Mode, aangepaste WAF regels en rate limiting.
Zie je dat Googlebot, Bingbot of een gewenste AI crawler een HTTP 403 krijgt? Kijk dan niet alleen naar AI Crawl Control.
Controleer je volledige Cloudflare configuratie.
Wat moet je vóór 15 september controleren?
Gebruik je Cloudflare? Loop dan in ieder geval deze punten na:
- Controleer binnen Cloudflare je instellingen voor Search, Agent en Training.
- Controleer of je Training op Block hebt staan.
- Controleer of je nog de oudere Block AI bots instelling gebruikt.
- Bepaal of je de nieuwe behandeling van mixed purpose Training crawlers per 15 september wilt overnemen. Bestaande klanten kunnen dit vóór de wijziging aangeven in de Security settings.
- Zorg dat Googlebot, Bingbot en andere belangrijke zoekmachine crawlers je website kunnen bereiken.
- Overweeg Bot Preference Sync als je Search wilt toestaan maar Training via Content Signals wilt beperken.
- Gebruik AI Crawl Control om ongewenste crawlers gericht te blokkeren.
- Controleer ook Bot Fight Mode, WAF regels en rate limiting.
- Gebruik waar nodig specifieke instellingen zoals Google Extended.
- Controleer na wijzigingen of alles daadwerkelijk werkt. Gebruik hiervoor de live URL test en crawlstatistieken in Google Search Console, controleer Bing Webmaster Tools en bekijk binnen Cloudflare Security Events of belangrijke user agents worden geblokkeerd.
Conclusie: blokkeer AI training niet ten koste van je vindbaarheid
De discussie over AI crawlers gaat vaak over één vraag: hoe voorkom je dat AI bedrijven je content gebruiken?
Maar voor bedrijven is een tweede vraag minstens zo belangrijk.
Hoe zorg je dat je website zichtbaar blijft op de plekken waar potentiële klanten zoeken en vergelijken?
Dat is Google en Bing, maar steeds vaker ook ChatGPT, Claude, Gemini en andere AI toepassingen.
Daarom is simpelweg alle AI bots blokkeren geen toekomstbestendige oplossing.
Maak onderscheid tussen Search, actueel AI gebruik en Training. Gebruik Disallow waar je een voorkeur wilt aangeven en Block alleen wanneer je een crawler daadwerkelijk technisch wilt weren.
En gebruik je Cloudflare? Controleer dan vooral vóór 15 september 2026 of je Training blokkeert. Anders kun je straks niet alleen AI training tegenhouden, maar ook crawlers zoals Googlebot en Bingbot raken.
Zo houd je controle over het gebruik van je content zonder onnodig je zichtbaarheid in zoekmachines en AI platformen op het spel te zetten.
Wil je weten of jouw website technisch goed toegankelijk is voor zoekmachines en hoe je beter zichtbaar kunt worden in Google en AI? Bekijk dan onze SEO diensten of neem contact op voor advies.

